好好行于当下

stay hungry stay foolish

好好行于当下

隔一段时间就忘记这个博客怎么启动、构建和部署,干脆记在这里,下次直接照着敲。

博客用的是 Hexo + NexT,下面的命令都在项目根目录执行。

常用命令

操作 命令
本地启动 npm run server
构建静态页面 npm run build
部署到 GitHub Pages npm run deploy
清理缓存和构建产物 npm run clean

本地启动后,打开 http://localhost:4000 就能预览,按 Ctrl+C 停止服务。构建后的静态文件在 public/ 目录里。

写完文章后部署

1
npm run clean && npm run build && npm run deploy

先清理,再构建,最后部署。修改之后先构建,可以确保发布的是最新内容。

部署目标在 _config.yml 中配置:通过 SSH 推送到 godshen/godshen.github.io 仓库的 main 分支,网站地址是 https://godshen.github.io/。部署时需要本机已有可访问该仓库的 GitHub SSH 密钥。

新电脑上先安装依赖

项目克隆下来后,在根目录执行:

1
npm ci

安装完成后,就可以使用上面的命令了。

一. AI时代还有什么是有意义的?

二. AI时代还有什么是有意义的?

三. AI时代还有什么是有意义的?

第一卷

1、 正义因本质而赐福于其所有者;不正义因本质而贻祸于其所有者。

2、 我们大家并不是生下来都一样的。个人禀赋不同,适合于不同的工作。

3、 一个人无论干什么事,错过有利的时机就会全功尽弃。

4、 你有没有注意到,昂扬的斗志,是何等不可抗拒而不可战胜吗?任何心灵又有了它,就可以无所畏惧,所向无敌。

5、 狗完全凭认识与否区别敌友——不认识的是敌,认识的是友。一个动物能以认识和不认识来确定自家人和外人,你怎么能说它不爱学习呢?

6、 故事有两种,一种是真的,一种是假的。

阅读全文 »

TODO

1、描述一下推荐系统的整个流程(架构)

推荐系统负责从海量的内容池中选择用户感兴趣的内容进行展示。整体上分为召回和排序两部分。整体上可以划分为召回、业务过滤、粗排、精排、重排混排、业务逻辑、最终展示这一流程。在召回阶段通过多路召回从海量数据池中得到小规模的候选数据;然后通过策略对部分内容进行过滤后传入排序阶段;粗排对召回数据进行初步排序筛选,是一个中和步骤,将候选集降低量级;精排对粗排结果使用更加精准的网络结构进行排序计算,圈定到目标范围的内容;为了符合一些多业务场景,还可以在精排后重排序,起到打散的作用;最后可以加入一些业务逻辑完成位次排列。

2、什么是多路召回,常见的召回路有哪些?

多路召回指采用不同的策略、特征或简单模型,分别召回一部分候选集,然后把候选集混合在一起供后续排序模型使用,“多路召回策略”是在“计算速度”和“召回率”之间进行权衡的结果,多路召回就像是一种集成学习,通过多条召回路平衡准确和全面。

常见的召回方式有基于内容的策略召回、协同过滤、图召回、深度网路召回等。基于内容的召回通常依赖NLP和CV等模型,深度神经网络以DeepFM、DSSM双塔等经典模型为主,图召回则可以构造社交网络或者依赖GNN模型。

阅读全文 »

let’s try something

最普通的等式 . 展示在句子里面可以吗

  • 带下标的概率关系(katex格式)
阅读全文 »

一. 背景

  • 我直播平台目前存在大量黑产, 表现为买关注刷人气等;
  • 直播风控上线近一年, 技术上保护了抽奖等相关接口, 同时更对营收起到了保护作用;
  • 本文阐述了风控在对抗黑产方面的工作进展, 计算对营收产生的影响, 并对未来加以预期以收获更好的成效.

二. 黑产流程

2.1 概念描述

  • 什么是黑产?

    黑产是黑/灰色产业的简称. 其通过非正当手段谋取利益, 俗称薅羊毛. 在我们的直播平台中, 黑产通过批量注册小号, 利用脚本大量刷辣条, 使得主播提升曝光的方式获取利益, 让本身是免费的辣条道具, 成为了他们赚钱的工具, 耗用的却是我们的资源;

黑产是风控的重点打击对象.

阅读全文 »

一. 学习内容

  1. 前馈神经网络 Feedforward Neural Network
  2. 卷积神经网络 Convolutional Neural Network
  3. 激活函数 Activation Function

1. 前馈神经网络

这里用depth只有1的灰度图来举例。 想要完成的任务是:在宽长为4x4的图片中识别是否有下图所示的“横折”。 图中,黄色圆点表示值为0的像素,深色圆点表示值为1的像素。 我们知道不管这个横折在图片中的什么位置,都会被认为是相同的横折。

阅读全文 »

一、学习内容

  1. Data Driven Approach 数据驱动的方法
  2. KNN K最近邻算法
  3. Linear classifiers 线性分类器
  4. Loss function 损失函数
  5. Optimization 优化
  6. Back propagation 反向传播
  7. Neural Networks 神经网络

1. 数据驱动

1.1 思路

dataset: labels –> train –> predict

1.2 CIFAR-10数据集

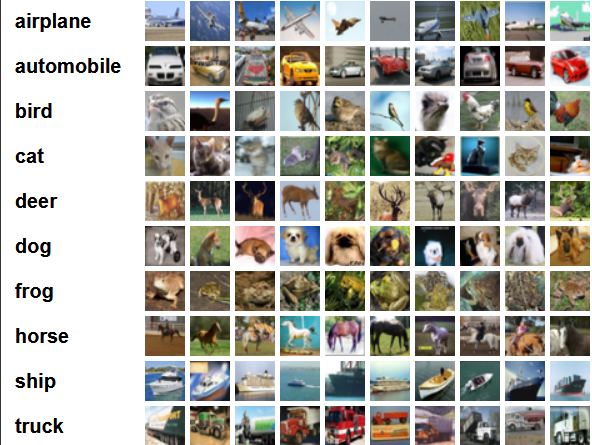
该数据集共有60000张彩色图像,这些图像是32*32,分为10个类,每类6000张图。这里面有50000张用于训练,构成了5个训练批,每一批10000张图;另外10000用于测试,单独构成一批。测试批的数据里,取自10类中的每一类,每一类随机取1000张。抽剩下的就随机排列组成了训练批。注意一个训练批中的各类图像并不一定数量相同,总的来看训练批,每一类都有5000张图。

阅读全文 »
0%